
マイニング用 GPU 1 枚で Qwen3.8-27B を、モデル本来の 262K コンテキストまで回した実測です。
decode を伸ばすために入れた MTP 投機と、その長文劣化を直した上流への修正も、過程として書いています。
NVIDIA CMP 170HX を1枚積んだ推論ホストで、Qwen3.8-27B を SGLang 0.5.19 で動かしています。
電力制限は 250 W、PCIe は Gen2 x16 です。
最近 Gen3 まで解放されたようですが Gen4 に出るまで待つのが良さそうです。
CMP 170HX は、解錠して初めて 64 GB の推論カードになる
CMP 170HX は GA100 ベースのマイニング専用カードです。
映像出力は無く、compute capability は 8.0(sm_80)です。
素の状態では VRAM が 8 GB と見え、SM も PCIe も制限がかかっています。
PCIe は Gen1 にクランプされます。
cmpunlocker を当てると、64 GB HBM2e、フル SM、PCIe Gen2(Gen3)、64 GB の BAR1 まで戻ります。
Proxmox ホスト側でこのドライバを持ち、LXC コンテナへ /dev/nvidia* を渡しています。
ゲストはホストと同じ 610.57.04 のユーザー空間ドライバを使います。
sm_80 であることは、推論スタックの選択に直結します。
SGLang の既定経路には Hopper(sm90+)前提のカーネルがあり、このカードでは踏めません。
attention と mamba は両方 Triton に固定しています。
--attention-backend triton
--mamba-backend triton
--sampling-backend pytorch
Qwen3.8-27B は 64層中48層が Gated DeltaNet(linear attention)です。
--mamba-backend は既定値も triton ですが、flashinfer に変えると sm_80 で落ちるので明示しています。
--sampling-backend pytorch の理由は後述の「踏んだ罠」に書きます。
電力制限は 250 W です。
300 W まで設定はできますが、250 W の時点で負荷中の消費電力の中央値が 248.8 W、SM クロックが 1455 MHz に張り付きます。
SM クロックは 170 W の時点から 1455 MHz で動いていません。
llama.cpp 時代の実測では、電力制限を 170 W から 200 W に上げて decode が +4.7%、200 W から 250 W で +4.2% でした。
170 W から 250 W の全区間でも +9.2% です。
電力を絞りたい拠点なら 170 W に落として 9% 諦めるのも成立する数字だと考えています。
エンジンを変えてもカードの電力特性は同じなので、SGLang でも 250 W のままにしています。
PCIe は Gen2 x16、実測のリンク速度は 5 GT/s です。
このモデルは、重みより Mamba 状態のほうが VRAM を食う
モデルは Qwen3.8-27B です。
アーキテクチャは Qwen3.5 で、64層のうち 48層が Gated DeltaNet、16層が full attention です。
モデル本来のコンテキストは 262144 token、vision tower と MTP head が付いています。
ベンチはエンジン比較ではなく、構成比較として読んでください。
GGUF は SGLang で読めないので、safetensors へ差し替えています。
本番のフラグは次のとおりです。
--context-length 262144
--max-running-requests 4
--mem-fraction-static 0.80
--speculative-algorithm NEXTN
--speculative-num-steps 3
--speculative-eagle-topk 1
--speculative-num-draft-tokens 4
--context-length は 1リクエストの上限です。
収容本数は --max-running-requests が別に持ちます。
llama.cpp は ctx_size が全 slot の合計で、1本の窓が --parallel で割れていました。
64 GB では --parallel 4、ctx 873472 で 1 slot が 218368 token、出力分を引いた実効の入力上限は 200704 token でした。
--parallel 5 は KV が 13.3 GiB 増えて 64 GB に載りません。
SGLang は radix cache を全 slot で共有するので、窓を割らずにモデル本来の 262144 を宣言できます。
移行の主目的はここです。
LLM 提供サービス(hai.hcloud.ltd) では、64K 超のプロンプトが全リクエストの 23.3% あります。
当時は 200704 を超えた分を、同時実行 1 本の別の推論ホストへ回していました。
VRAM の内訳は、dense モデルの感覚で見ると外れます。
投機なし・--mem-fraction-static 0.9 の起動ログでは、次のように出ていました。
Load weight end.  mem usage=17.75 GB
Mamba Cache is allocated.  conv_state 0.35GB, ssm_state 18.00GB
KV Cache is allocated.     K 10.24 GB, V 10.24 GB  (#tokens 335679)
Memory pool end.  avail mem=6.39 GB
重みは 17.75 GB です。
Mamba の ssm_state が 18.00 GB あり、conv_state 0.35 GB と合わせると重みより大きいです。
64層中48層が Gated DeltaNet であることのコストで、このモデルに特有です。
KV は K と V で 20.48 GB、このときの max_total_num_tokens は 335679 です。
そのあと CUDA graph のキャプチャが空きを食うので、実測 VRAM は 63501 MiB / 65536 MiB まで乗っていました。
MTP の draft は本体と別の ModelRunner を作るので、重み 0.85 GB に加えて compute buffer と CUDA graph の分が要ります。
--mem-fraction-static 0.85 のままだと draft ロード中に OOM し、投機なしへ黙って落ちます(後述)。
本番は 0.80 で、max_total_num_tokens は 268304、起動後の空きは 13.8 GB です。
4 並列すべてが 245K を使い切ることは KV 上できませんが、実トラフィックでそこまで埋まったことはありません。
同じカードで prefill は約 2 倍、245K token まで入った
計測は 2026-09-06、llama.cpp v0.4.0 から SGLang 0.5.19 へ移した直後の値です。
この時点の SGLang は投機なしです。
prefix cache はユニーク prefix と cache_prompt: false で外しています。
生成は 128 token、単発です。
llama.cpp 側は FastMTP depth 2、--parallel 4、KV q8_0、-b 512 です。
prefill
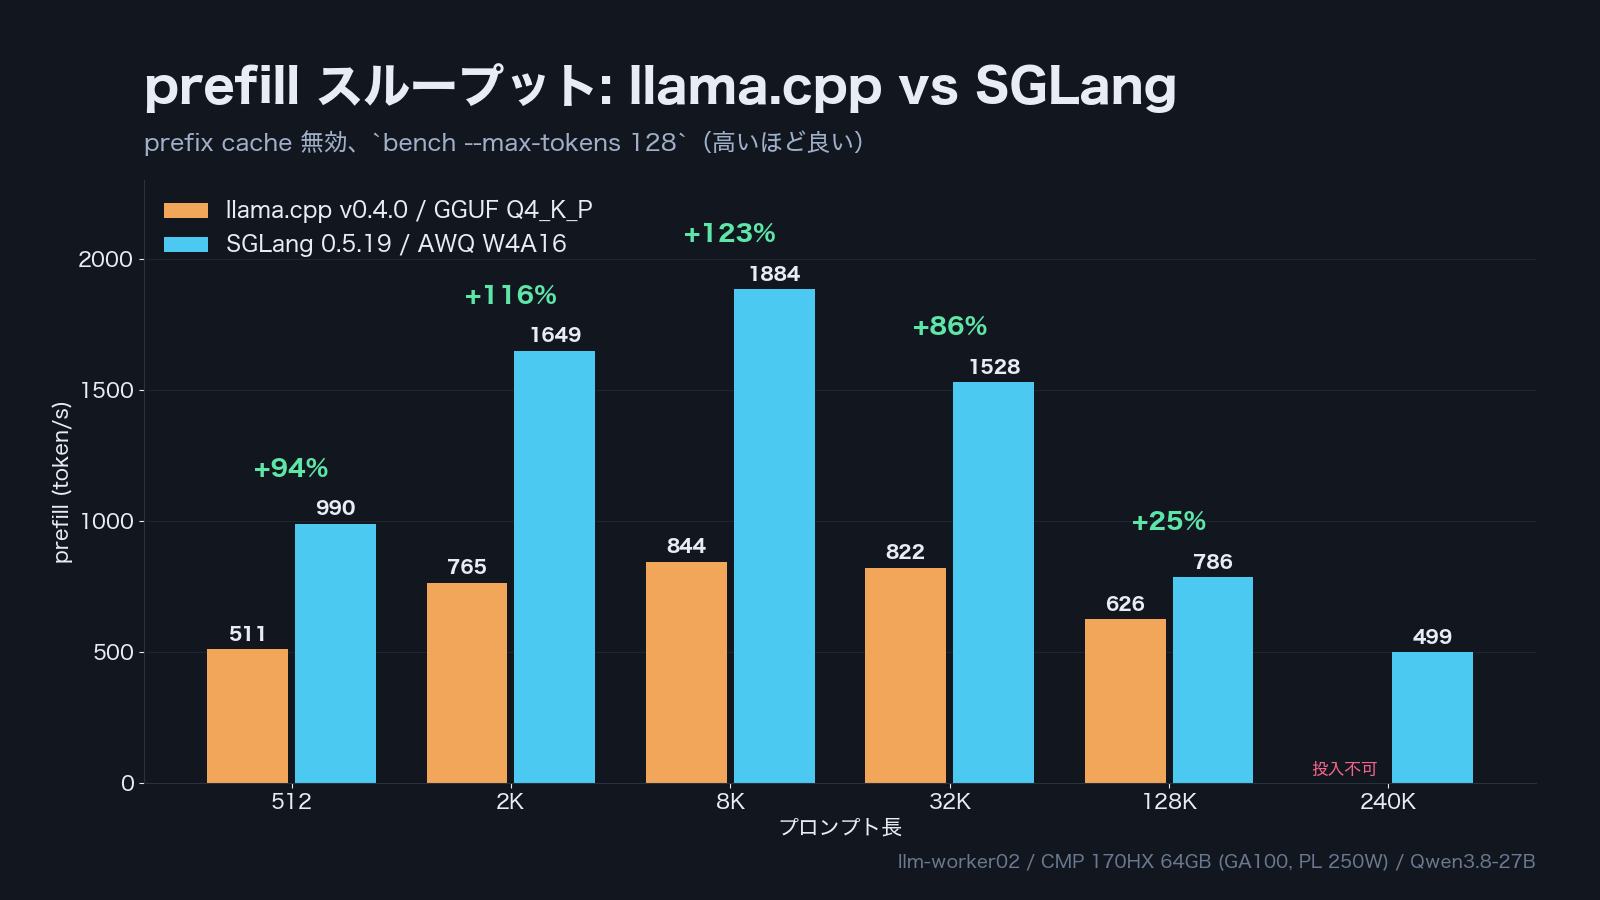
8K で 843.6 token/s から 1883.8 token/s です。
llama.cpp 時代は、cold prefill 730〜860 token/s を GA100 の compute 天井と読んでいました。
同じカード・同じ 250 W で 1883.8 token/s 出るので、天井はエンジン側でした。
245760 token は llama.cpp では窓 200704 を超えるため投入できません。
SGLang では prefill 499.1 token/s で入りました。
実プロンプト長は 245724 token です。
TTFT
単位は ms、小さいほど速いです。
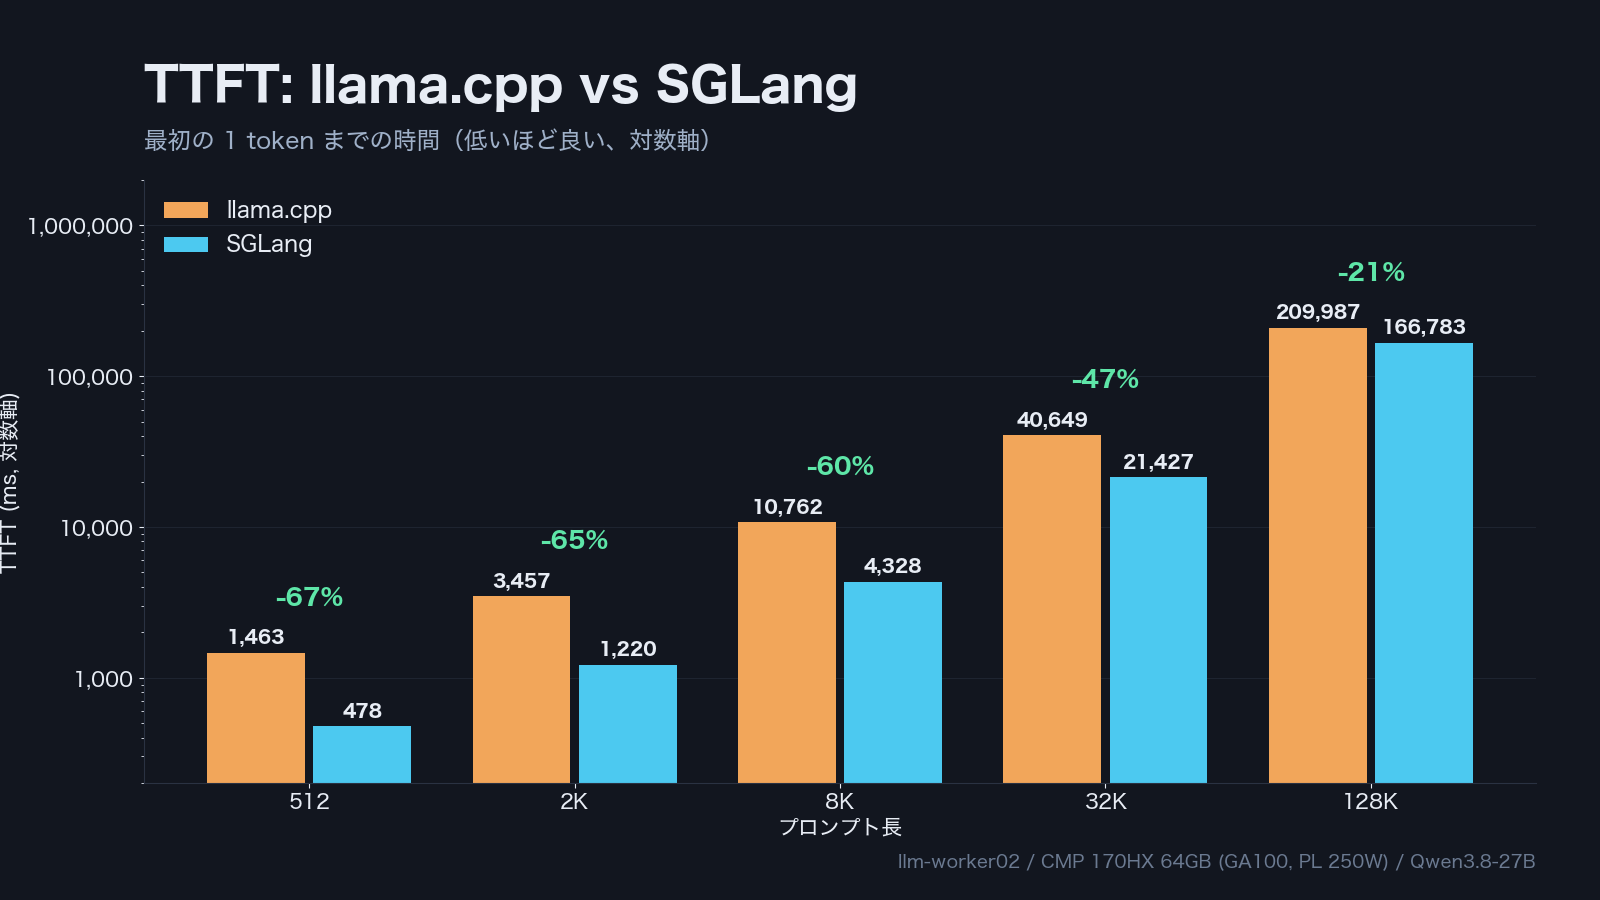
8K で約 10.8 秒から約 4.3 秒です。
128K でも約 210 秒から約 167 秒まで縮んでいます。
長いプロンプトの待ちは prefill そのものなので、ここの差が体感に出ます。
decode(投機なしの SGLang)
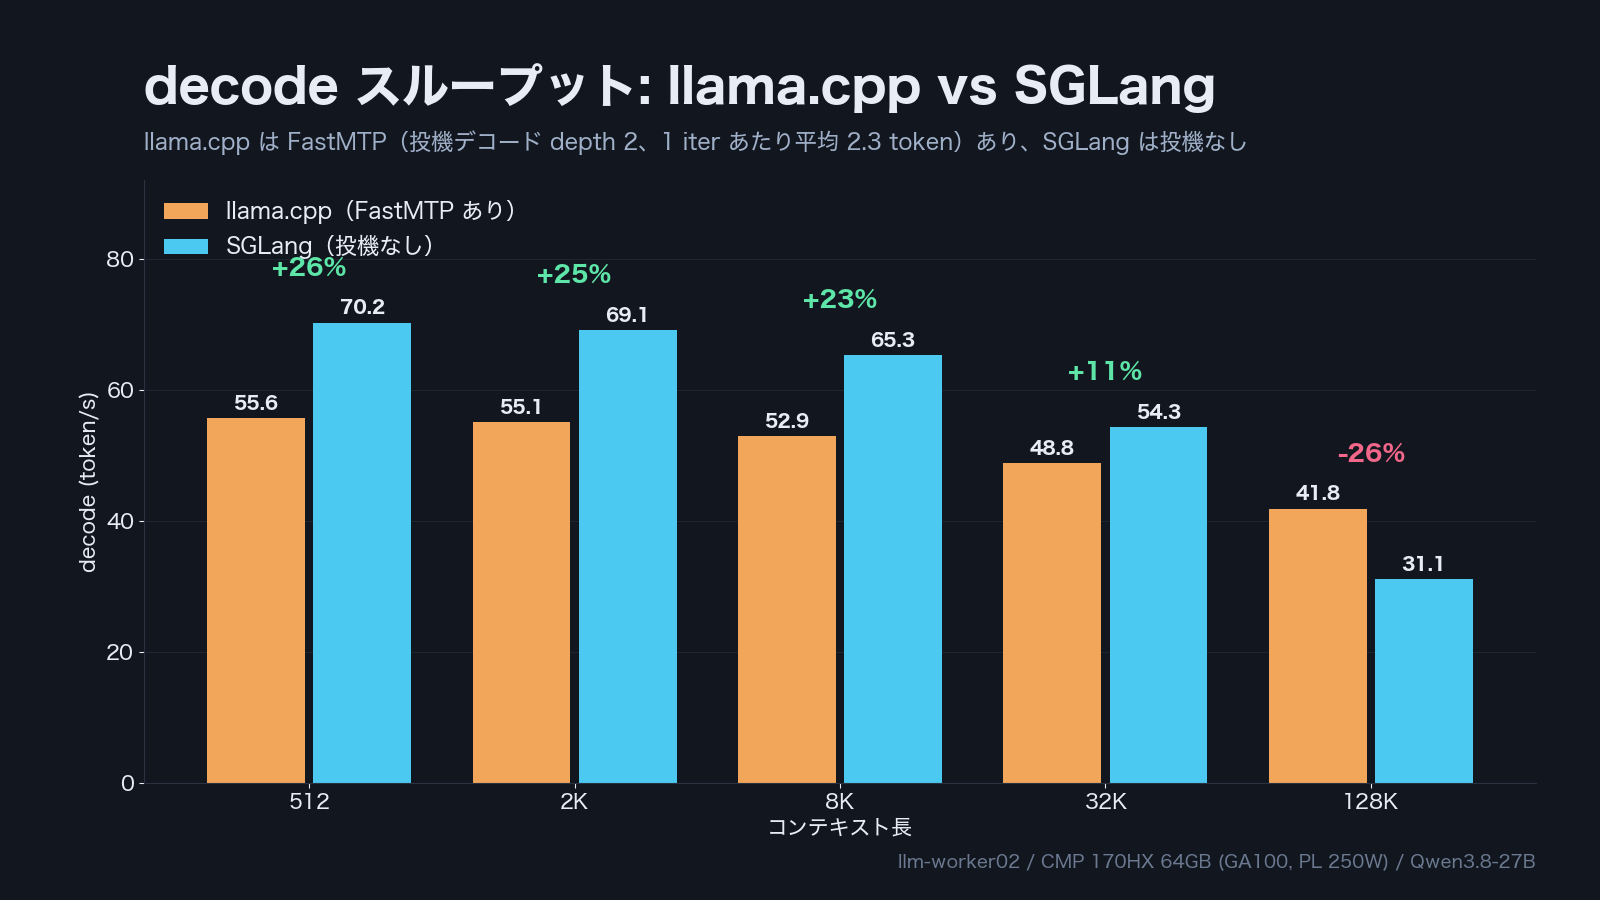
32K までは SGLang が速く、128K だけ llama.cpp が上です。
llama.cpp は FastMTP depth 2 で、1イテレーションあたり平均 2.3 token 出しています。
SGLang 側は当時、投機を入れていません。
同時実行
8K プロンプト、256 token 生成です。
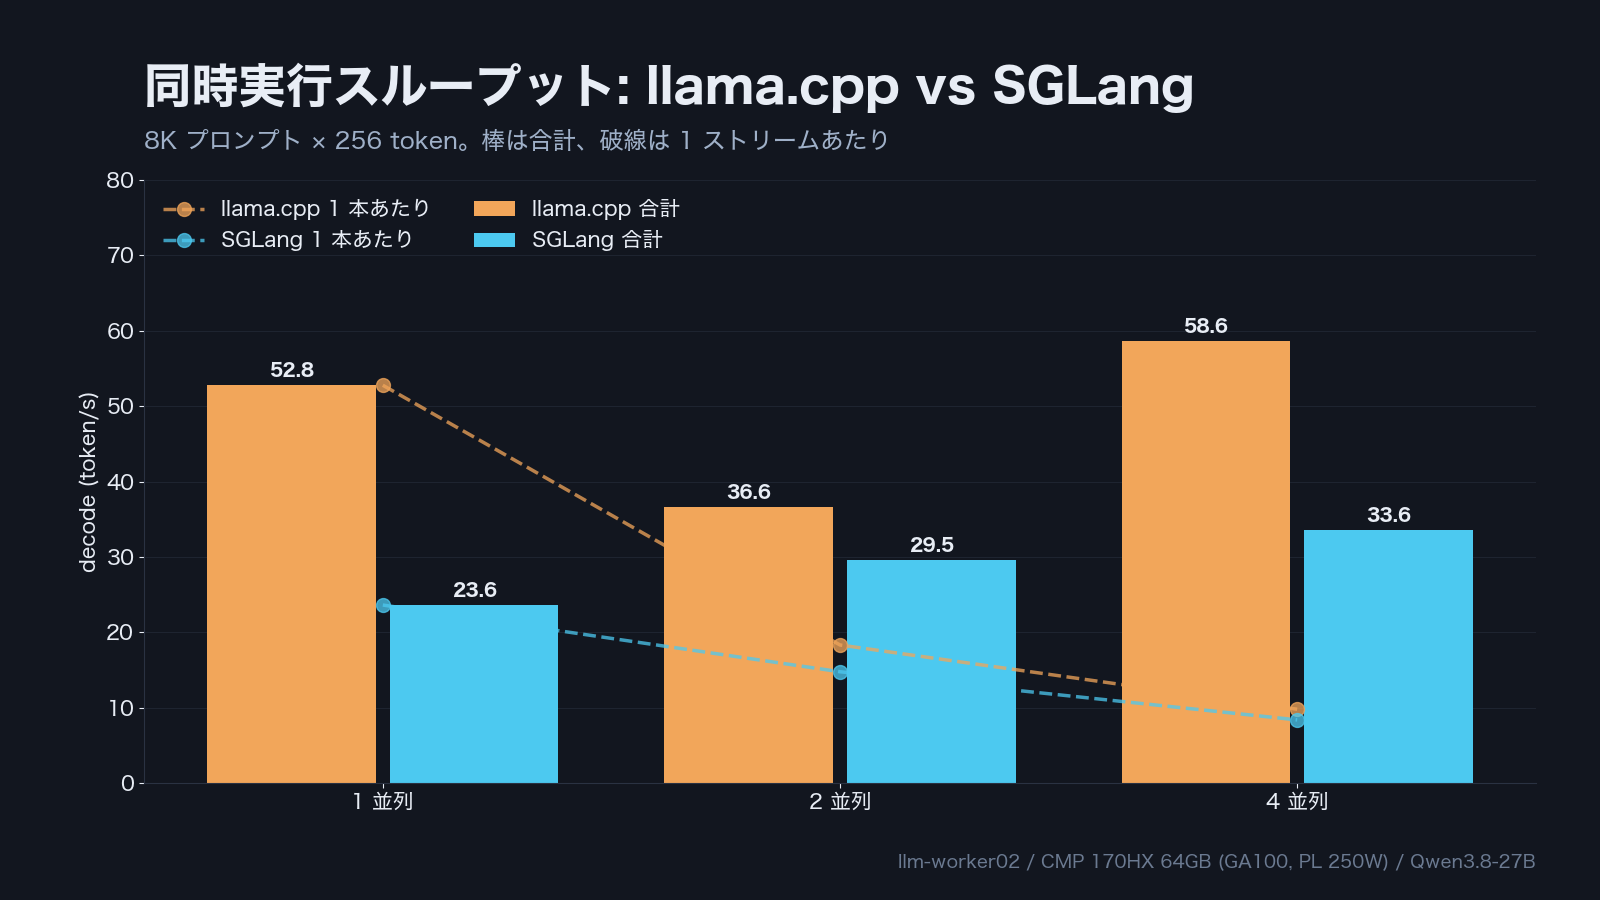
4並列の合計 decode は llama.cpp が 58.62、SGLang が 33.57 です。
「SGLang は同時実行に強い」という一般論は、この構成では成立していません。
1本だけの差が最大なので、投機の有無がほぼそのまま出ていると当時は読んでいました。
llama.cpp の conc=2 が conc=1 を下回るのは head-of-line blocking です。
llama-server は 1イテレーションで、生成中 slot の 1 step と pending prompt を最大 -b token しか回しません。
-b 512 にしても、8K の prefill が互いを巻き込みます。
なお、この表の値は SGLang では timings が返らないため壁時計から出しており、prefill の時間を含みます。
decode だけを比べた数字は次の節の 4 並列表のほうが正確です。
context window
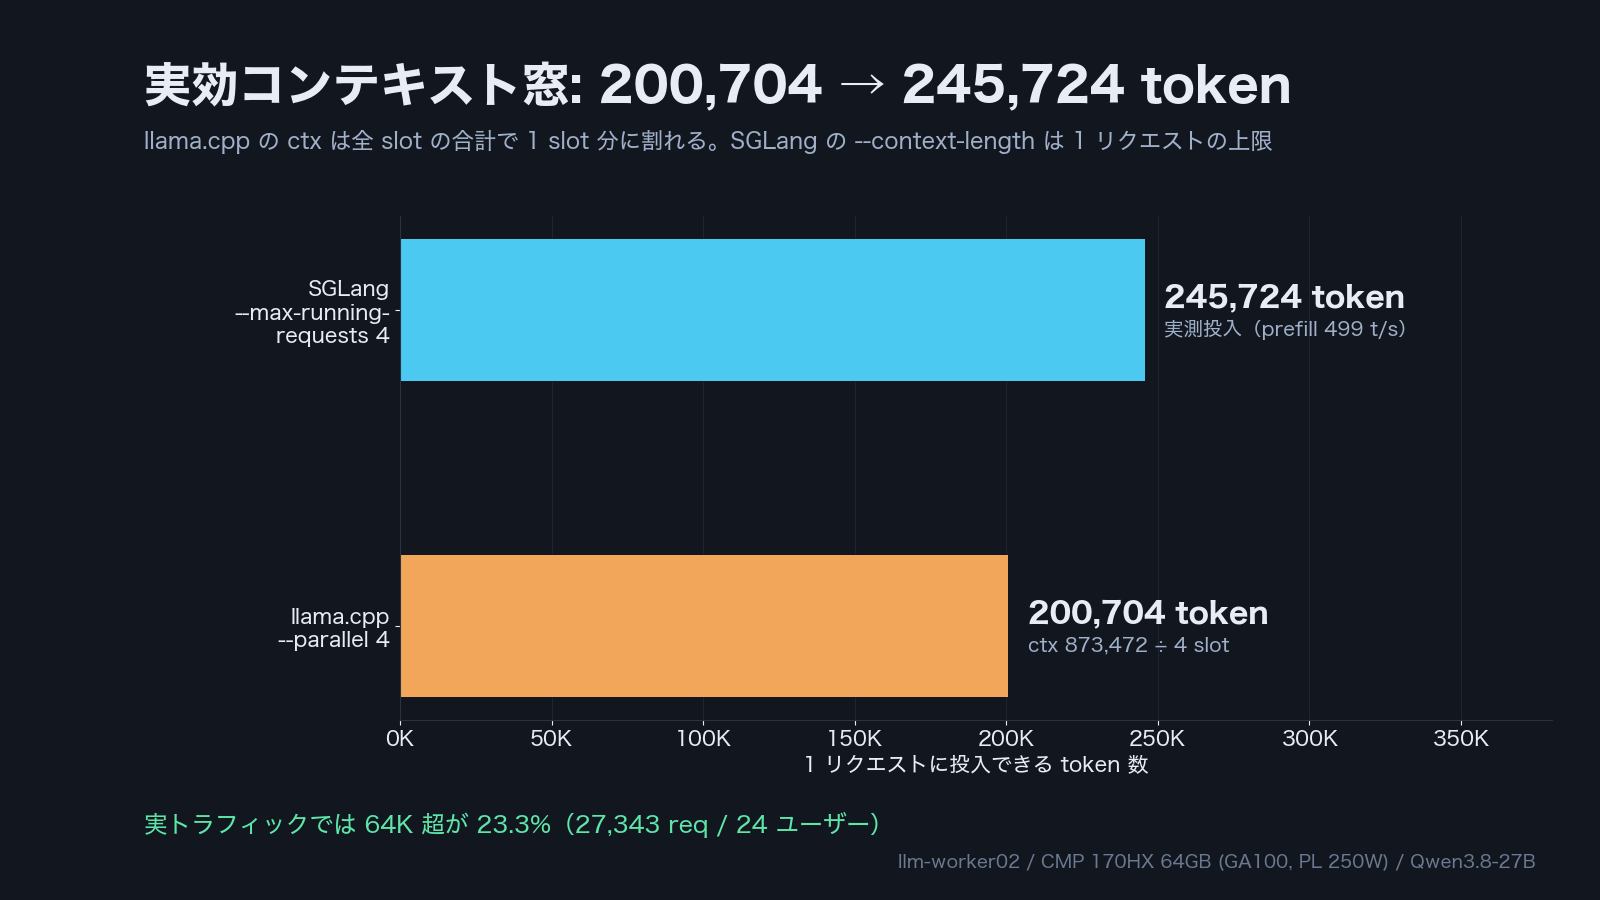
llama.cpp の実効窓は 200704 token、SGLang は 245724 token を実投入できています。
--context-length 262144 を宣言しても、入る長さは起動ログの max_total_num_tokens と KV の残り次第です。
245760 は投入確認が目的で、decode の比較対象にはしていません。
取ったのは窓と TTFT です。
decode の合計スループットは、この時点では llama.cpp 側に残していました。
投機デコード
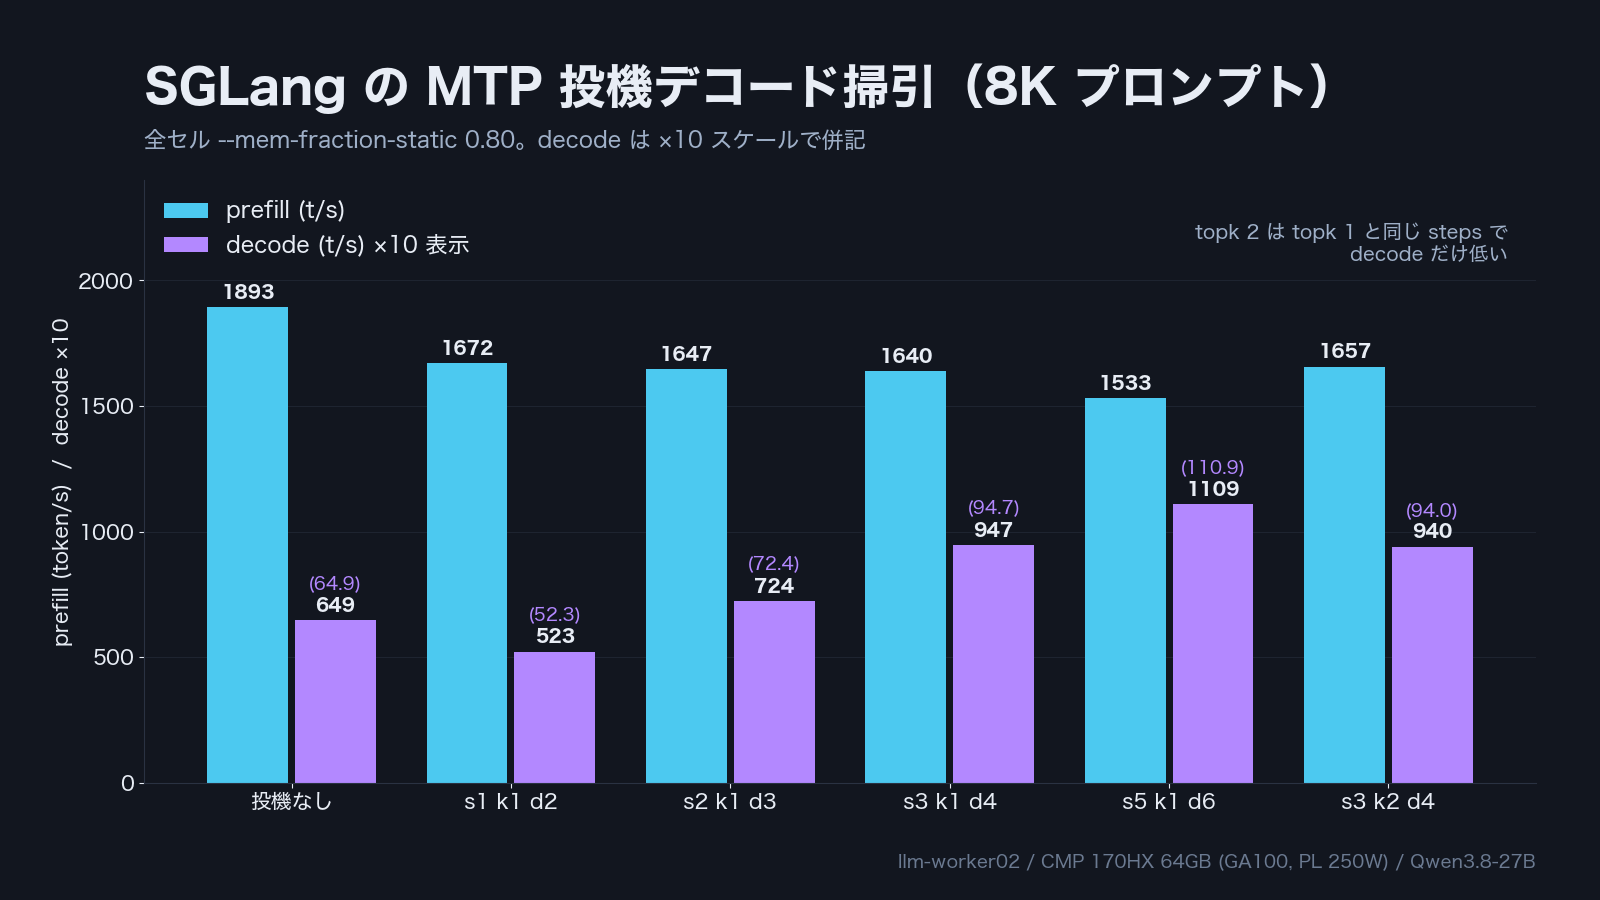
移行前の FastMTP に対して、SGLang 側は --speculative-algorithm NEXTN の steps / topk / draft_tokens を振って測っています。
採用したセルは steps 3、topk 1、draft_tokens 4(s3 k1 d4)です。
--mem-fraction-static は 0.80 で揃えています。
最初の検証(2026-09-06)では、短文の decode は 3 倍近く出ました。
512 で 69.6 token/s から 209.4 token/s です。
32K を境に投機なしより遅くなり、128K では 31.1 token/s から 10.1 token/s まで落ちました。
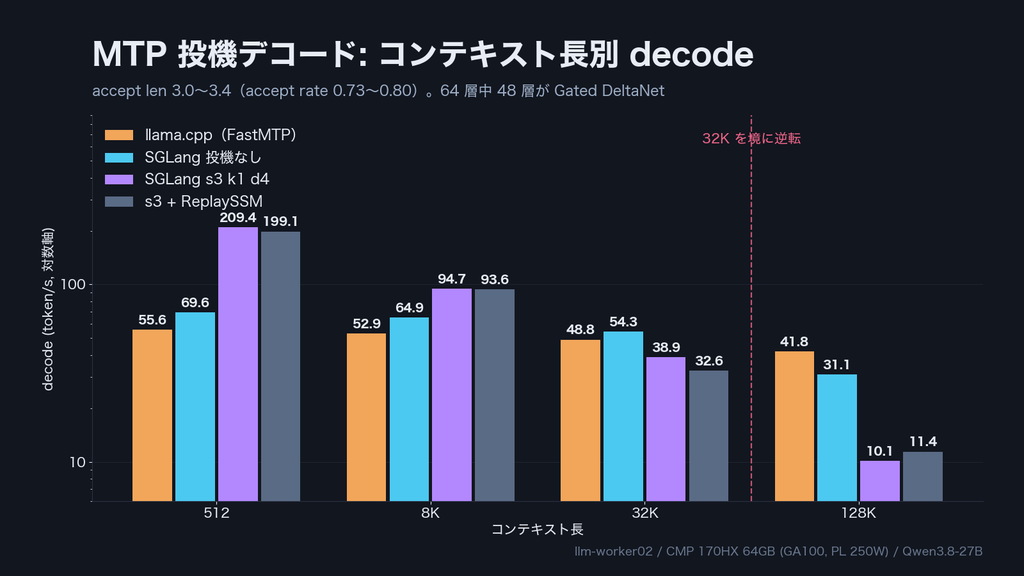
llama.cpp の 128K は 41.8 token/s なので、投機を入れた SGLang が一番遅くなります。
accept len は長文でも 3.0〜3.4(accept rate 0.73〜0.80)で、予測は当たっています。
当たっているのに、ログ上の生成は 0.65 token/s まで落ちていました。
最初は Gated DeltaNet の状態スナップショットが原因だと考えました。
hybrid モデルの投機では、棄却された draft の影響を巻き戻すために draft ごとに状態のコピーを持つ必要があり、SGLang もそう実装しています。
そのコピーが文脈長に比例して重くなる、という仮説です。
per-draft のスナップショットをやめる --enable-linear-replayssm-spec を入れても 10.1 から 11.4 token/s にしかならず、これが反証でした。
Gated DeltaNet の状態は head 数と head 次元で決まる固定サイズで、文脈長には依存しません。
linear attention と呼ばれる理由がまさにそれで、この仮説は前提から成り立っていませんでした。
文脈長に比例してコストが増える場所は、full attention 16 層の verify しかありません。
Triton backend の target_verify は prefill 用カーネル extend_attention_fwd で動いていました。
grid が (batch, head_num, cdiv(draft_tokens, BLOCK_M)) なので、draft 4 token では 1リクエストあたり head 数分の 24 program しか立ちません。
各 program が 131K の prefix を BLOCK_N=64 ずつ直列にスキャンします。
通常 decode は同じ prefix を num_kv_splits=8 に割って並列に読むので、verify の並列度は decode の 1/8 です。
prefix が伸びるほど verify 1 回のコストが線形に増え、32K を境に「1 step で 3 token 出せる」利得を食い潰します。
flash-decode 型の verify カーネル verify_splitkv_fwd は 0.5.19 に同梱済みで、docstring がまさにこの症状を書いています。
呼び出し側が is_gfx95_supported()(AMD MI350X 系)でゲートしており、CUDA では一度も走りません。
カーネル本体は HIP 専用の launch 引数を _IS_HIP で分岐していて、コメントにも CUDA CI で数値テストを回すために NV-safe に保っていると書かれています。
直すのはゲートの1行で、修正後はこうなります。
self.use_verify_splitkv = (
    envs.SGLANG_ENABLE_SPLITKV_VERIFY.get()
    and self.topk == 1
)
SGLANG_ENABLE_SPLITKV_VERIFY=0 で従来経路に戻せます。
上流の数値テスト test_verify_splitkv.py(9ケース)を sm_80 の CUDA で回し、全件通ることを確認しました。
上流 main(2026-09-14 取得)も同じゲートだったので、PR #39316 を送っています。
社内では Ansible から site-packages に patch を当てる形で配布し、取り込まれたら外します。
修正後の decode(cold、128 token 生成、token/s)です。
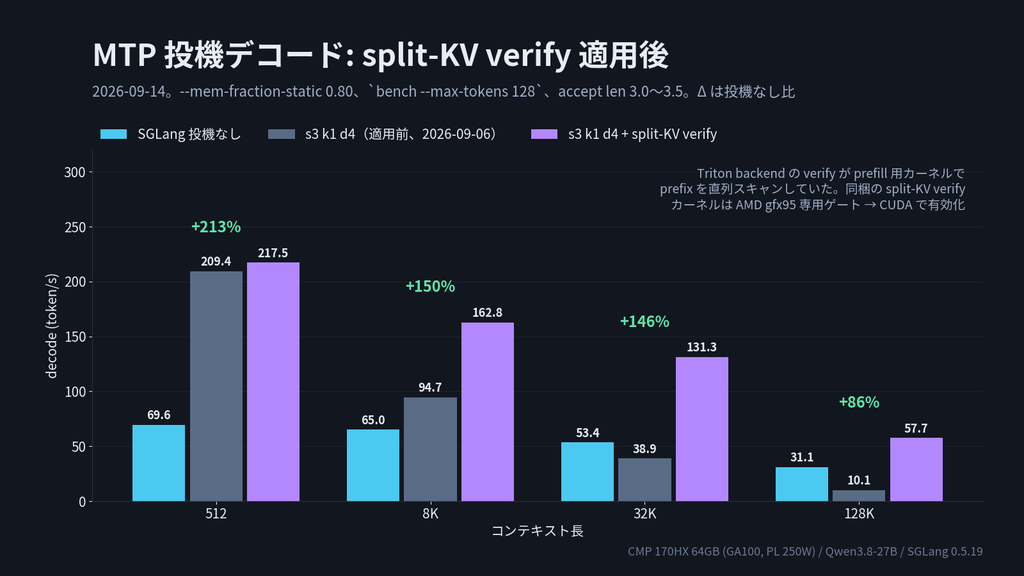
32K の逆転は消え、128K は 10.1 から 57.7 token/s です。
llama.cpp の FastMTP が出していた 41.8 token/s も超えています。
accept len は修正前後とも 3.0〜3.5 で、変わったのは verify カーネルだけです。
prefill は投機なし時の値を上に書いています。
投機を入れると 512 で -23%、8K 以降は -4〜5% です。
draft 起動の固定コストが毎リクエスト乗るためで、split-KV とは無関係です。
4並列では、投機の利得はほぼ消えます。
単発クライアントを 4本同時に流した per-stream decode の合計(512 token 生成)です。
| prompt | 投機なし | s3 + split-KV |
|---|---|---|
| 8192 | 222.7 | 235.0 |
| 32768 | 171.9 | 156.4 |
8K は 222.7 から 235.0、32K は 171.9 から 156.4 で、差は ±8% です。
draft の verify がバッチ全体の 1 step を長くします。
GPU が埋まる並列度では、「空いた compute を投機に使う」前提が崩れると考えています。
このホストは --max-running-requests 4 で、実トラフィックの大半は 1〜2並列です。
単発から2本までの利得を取る判断にしています。
終わりに
マイニング用の CMP 170HX を解錠して 64 GB にし、Qwen3.8-27B を1枚で回すと、8K の prefill は 1883.8 token/s、128K の decode は MTP 込みで 57.7 token/s 出ます。
245724 token も同じカードに入ります。
窓が parallel で割れないことと、prefill の天井がカードではなくエンジン側だったことが、llama.cpp から移した理由です。
decode は投機で取り返し、長文側は Triton の verify ゲートを1行外して 57.7 token/s まで戻りました。
その1行は上流に PR として送っています。
https://github.com/sgl-project/sglang/pull/39316